Détection des situations à risque à partir des données métier d’assurance
La détection des situations à risque à partir des données métier désigne une démarche méthodologique consistant à exploiter les informations issues de l’activité d’un organisme d’assurance pour repérer, au sein d’un grand nombre de dossiers, ceux qui nécessitent une vigilance particulière, une analyse des dossiers plus approfondie, un blocage, un contrôle ou une priorisation décisionnelle. Elle ne se limite pas à la lutte contre la fraude au sens strict. Elle vise plus largement à identifier des configurations atypiques, sensibles ou incohérentes susceptibles de traduire un risque financier, documentaire, opérationnel ou décisionnel.
Dans le secteur de l’assurance, cette démarche repose sur l’idée qu’un contrat, un sinistre, une prestation, un arrêt de travail, une déclaration ou un parcours de gestion laissent des données métier d’assurance : dates, montants, historiques, pièces, intervenants, décisions successives, récurrences ou séquences de traitement. Observées de manière structurée, ces informations permettent de faire émerger des signaux faibles ou forts, de nourrir la détection d’anomalies et de mieux cibler les situations qui justifient un examen renforcé ou un blocage.
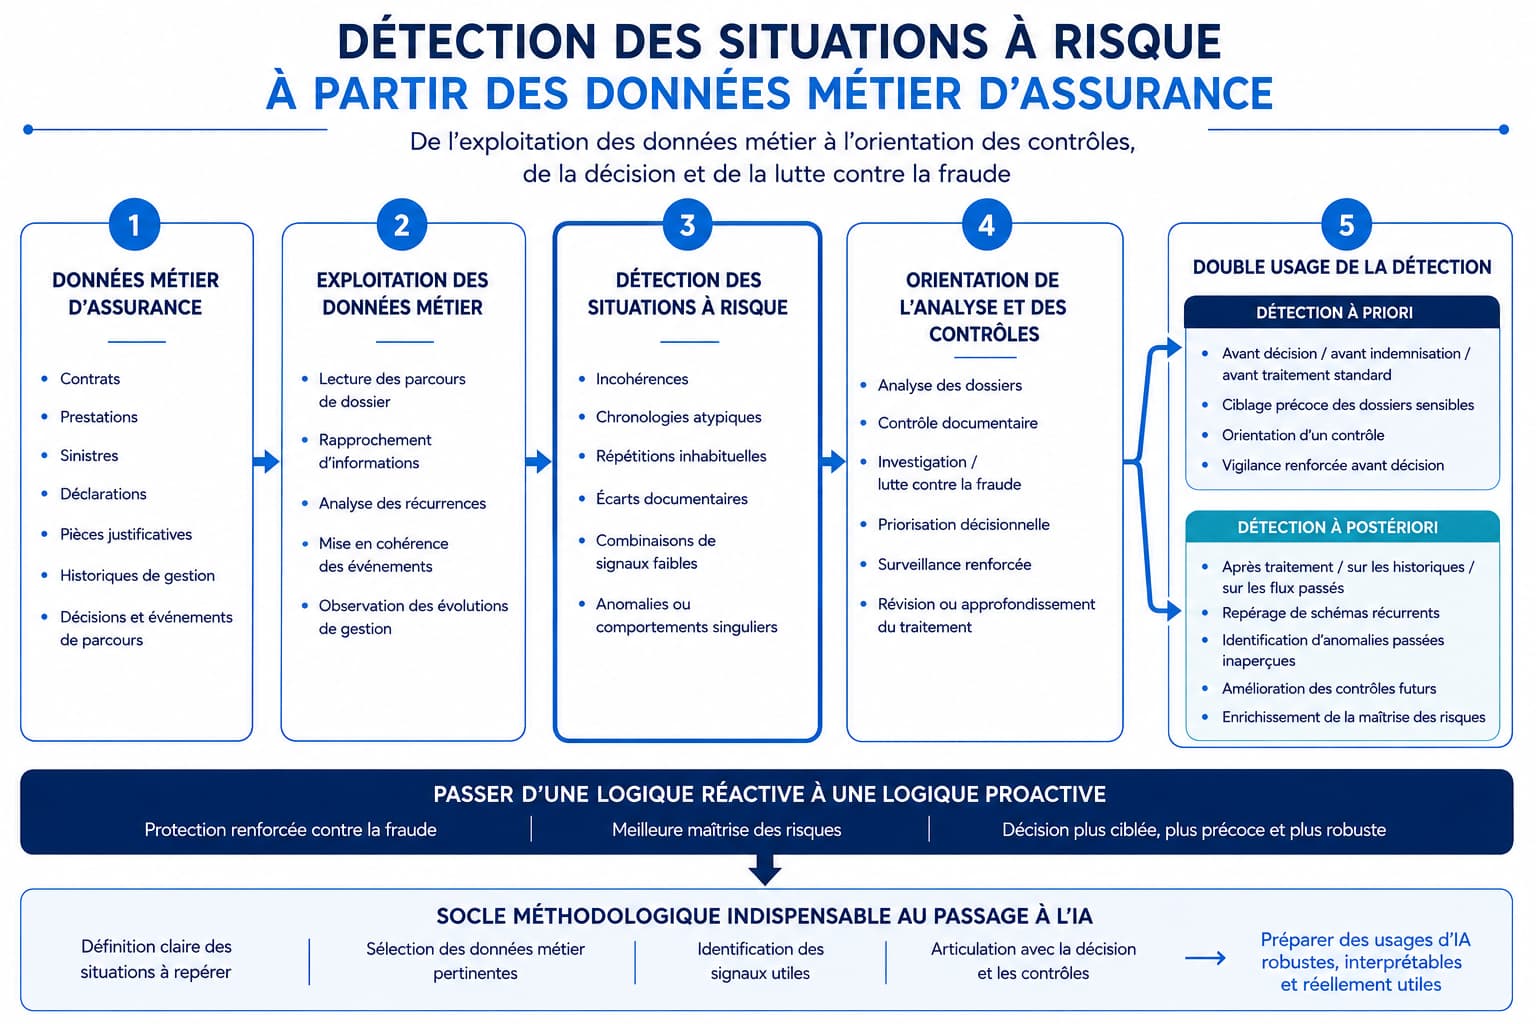
L’un des apports majeurs de cette démarche est qu’elle permet d’agir à deux moments complémentaires : à priori, avant qu’un dossier ne suive son traitement standard, qu’une décision ne soit finalisée ou qu’une indemnisation ne soit versée ; et à postériori, à partir des dossiers déjà traités, des flux historiques ou des prestations versées, afin de repérer des schémas récurrents, des anomalies passées inaperçues ou des situations nécessitant une réévaluation. En cela, la détection des situations à risque permet de faire évoluer l’organisation d’une logique essentiellement réactive, fondée sur les remontées, les doutes ou les contrôles tardifs, vers une logique plus proactive, structurée autour de l’anticipation, de l’observation et de l’orientation des dossiers sensibles.
Cette démarche est aujourd’hui devenue centrale non seulement pour renforcer la maîtrise des risques, mieux orienter les contrôles, structurer la lutte contre la fraude et améliorer l’exploitation des données, mais aussi parce qu’elle constitue un prérequis méthodologique à une IA utile en assurance. Avant de chercher à automatiser, prédire ou scorer, l’organisme doit d’abord savoir quelles situations il cherche à repérer, quelles données sont pertinentes, quels signaux ont du sens et comment relier l’analyse à une décision métier. La détection des situations à risque constitue précisément ce travail de structuration préalable.
Les organismes d’assurance traitent chaque jour un volume important de dossiers, de demandes, de prestations, de sinistres, de justificatifs et d’événements de gestion. Cette masse d’informations couvre des réalités très différentes : contrats, remboursements, arrêts de travail, prestations santé, déclarations de sinistres, demandes d’indemnisation, pièces médicales, expertises, échanges avec les assurés ou avec des tiers. Dans cet environnement, la difficulté n’est pas seulement de disposer de données. Elle réside surtout dans la capacité à repérer, au bon moment, les situations qui méritent une attention renforcée.
La problématique métier à laquelle répond la détection des situations à risque est donc d’abord une problématique de visibilité. Tous les dossiers ne présentent pas le même niveau d’enjeu, le même degré de sensibilité ni le même besoin d’analyse. Pourtant, dans de nombreuses organisations, les équipes opérationnelles se trouvent confrontées à une tension structurelle : elles doivent traiter des flux nombreux, hétérogènes et parfois urgents, tout en étant capables d’identifier ceux qui sortent de l’ordinaire. Or cette identification ne peut pas reposer uniquement sur l’intuition, sur l’expérience individuelle des gestionnaires ou sur des contrôles uniformes appliqués indistinctement à l’ensemble des dossiers.
Mais la problématique métier ne se limite pas à la capacité de “voir” les dossiers sensibles. Elle concerne aussi le moment auquel l’organisation parvient à les identifier. Dans de nombreux dispositifs, la vigilance intervient encore de façon principalement réactive : un dossier attire l’attention parce qu’un gestionnaire exprime un doute, parce qu’une incohérence est repérée tardivement, parce qu’un signalement est remonté, parce qu’un contrôle intervient après paiement ou parce qu’une anomalie apparaît une fois le traitement déjà engagé. La détection des situations à risque à partir des données métier d’assurance répond précisément à cette limite. Elle vise à donner à l’organisme la capacité d’identifier certaines situations à priori, avant qu’elles ne suivent leur parcours standard, mais aussi à postériori, à partir des flux déjà traités, afin de repérer des schémas passés inaperçus et d’améliorer la compréhension des risques. En cela, elle constitue un levier pour faire évoluer les pratiques d’une logique de réaction ponctuelle vers une logique de vigilance plus proactive.
En ce sens, la détection des situations à risque constitue une réponse à une question très concrète pour les organismes d’assurance : comment repérer, dans un grand volume de dossiers, ceux qui ne doivent pas être traités comme les autres, et comment le faire suffisamment tôt — ou suffisamment intelligemment après coup — pour orienter utilement la décision, le contrôle et la lutte contre la fraude ?
Si la détection des situations à risque à partir des données métier d’assurance occupe aujourd’hui une place centrale, c’est d’abord parce que le secteur de l’assurance est confronté à une transformation profonde de ses volumes, de ses flux et de ses exigences de pilotage. Les organismes disposent de quantités croissantes d’informations issues des contrats, des sinistres, des prestations, des historiques de gestion, des échanges avec les assurés, des justificatifs, des outils de contrôle ou encore des systèmes de décision. Cette richesse informationnelle constitue un actif considérable, mais elle crée en parallèle une difficulté structurelle : plus les flux sont nombreux, plus les situations sont hétérogènes, et plus il devient difficile d’identifier rapidement les dossiers qui nécessitent une attention particulière.
Cette difficulté tient au fait que les situations à risque sont rarement visibles de manière immédiate. Elles ne prennent pas toujours la forme d’une anomalie évidente ou d’une irrégularité manifeste. Elles apparaissent souvent au croisement de plusieurs éléments : une succession d’événements, une évolution atypique d’un dossier, une chronologie peu cohérente, une répétition inhabituelle, un écart entre des pièces, un comportement déclaratif singulier ou une combinaison de facteurs qui, pris isolément, semblent anodins mais qui, rapprochés, justifient une vigilance renforcée. Sans une démarche structurée d’exploitation des données, une part importante de ces signaux reste noyée dans le flux courant et ne peut être repérée qu’au prix d’efforts humains considérables, souvent tardifs.
La démarche est également devenue indispensable parce que les organismes d’assurance doivent faire face à une contrainte croissante de priorisation décisionnelle. Les équipes de gestion, de contrôle, d’indemnisation ou de lutte contre la fraude ne disposent pas de ressources illimitées. Elles doivent arbitrer, sélectionner, approfondir certains dossiers, parfois dans des délais courts, tout en maintenant un niveau élevé de qualité de traitement. Dans ce contexte, la détection des situations à risque joue un rôle essentiel : elle permet de distinguer les dossiers pouvant suivre un traitement standard de ceux qui justifient un regard renforcé, une analyse des dossiers plus poussée, un contrôle documentaire ou une orientation spécifique.
Mais cette démarche est devenue indispensable pour une raison plus structurante encore : elle constitue aujourd’hui l’un des socles méthodologiques de l’intelligence artificielle en assurance. Beaucoup d’organismes expriment le souhait de “faire de l’IA” pour détecter la fraude, orienter les dossiers, automatiser certains contrôles ou améliorer la décision. Cette ambition est compréhensible, mais elle repose parfois sur une représentation trompeuse : celle d’une technologie qu’il suffirait d’activer pour obtenir automatiquement une détection pertinente des dossiers sensibles. Or, dans les faits, une IA ne remplace ni la compréhension du métier, ni la définition du problème, ni le travail de structuration des informations utiles. Elle ne sait pas, par elle-même, ce qu’un assureur considère comme une situation à risque, quels signaux doivent être surveillés, quelles incohérences ont une signification métier, ni comment les résultats doivent être utilisés dans les processus de gestion.
Autrement dit, avant même de parler de modèle, d’automatisation ou d’algorithme, un organisme doit être capable de répondre à des questions beaucoup plus fondamentales : quelles situations cherche-t-on réellement à repérer ? quelles données métier d’assurance sont pertinentes pour le faire ? quels signaux ont du sens dans une branche donnée ? comment distinguer une anomalie, un simple bruit de gestion, un besoin de contrôle ou un risque plus structurant ? à quel moment du parcours de gestion la vigilance doit-elle intervenir ? Tant que ces questions ne sont pas clarifiées, l’IA risque de reposer sur un problème mal formulé, sur des données mal sélectionnées ou sur des usages mal définis.
C’est précisément pour cette raison que la détection des situations à risque à partir des données métier est devenue un passage obligé. Elle oblige l’organisation à expliciter ce qu’elle cherche à observer, à sélectionner les données réellement utiles, à identifier des signaux faibles, à comprendre les logiques de parcours, à confronter l’analyse aux réalités opérationnelles et à relier les résultats à une décision ou à un contrôle concret. En ce sens, elle ne constitue pas seulement un outil de vigilance ; elle représente aussi un travail de formalisation indispensable pour qu’une démarche d’IA puisse produire quelque chose de robuste, d’interprétable et d’actionnable.
Cette articulation entre exploitation des données et IA est déterminante. Une IA utile en assurance ne se construit pas à partir d’un stock de données pris comme un bloc homogène. Elle se construit à partir de cas d’usage définis, de problématiques métier cadrées, de données sélectionnées et comprises, de signaux interprétés dans leur contexte et d’une chaîne de décision capable d’utiliser les résultats. Sans ce socle, l’IA risque de devenir une surcouche technologique appliquée à des flux mal structurés, avec des résultats difficilement interprétables, peu fiables ou déconnectés des besoins des équipes. À l’inverse, une démarche solide de détection des situations à risque crée un terrain favorable à l’industrialisation de dispositifs analytiques plus avancés, parce qu’elle transforme un objectif abstrait, “détecter mieux” , en une problématique concrète, documentée et exploitable.
Le premier objectif d’une démarche de détection des situations à risque est de faire émerger, au sein d’un volume important de dossiers, ceux qui nécessitent une vigilance particulière. Il ne s’agit pas de classer tous les dossiers, ni de produire d’emblée une conclusion sur leur nature. L’enjeu est d’identifier les situations qui se distinguent du flux courant par leur profil, leur comportement, leur chronologie, leur niveau d’exposition ou la combinaison d’informations qu’elles présentent. Cette première fonction de repérage est essentielle : elle permet d’éviter que des dossiers sensibles restent invisibles simplement parce qu’ils se trouvent noyés dans la masse.
Le deuxième objectif est de mieux orienter les capacités d’analyse et de contrôle. Une détection utile n’a pas vocation à produire une liste abstraite d’alertes. Elle doit au contraire aider l’organisation à savoir où porter son attention. Cela signifie repérer les dossiers pour lesquels un contrôle documentaire, une vérification complémentaire, une analyse métier plus approfondie ou une priorisation de traitement peut être justifiée. La détection joue ici un rôle d’aiguillage : elle contribue à concentrer les efforts là où ils ont le plus de sens.
Le troisième objectif est de renforcer la lutte contre la fraude en améliorant la capacité de l’organisme à repérer des situations qui, sans constituer immédiatement une preuve, présentent des caractéristiques suffisamment atypiques pour justifier une vigilance renforcée. Une fraude ne se manifeste pas toujours par un signal unique et évident. Elle peut se dessiner à travers des incohérences documentaires, des répétitions, des évolutions de comportement, des rapprochements entre dossiers ou des séquences de gestion inhabituelles. La détection des situations à risque permet précisément de structurer cette observation et d’orienter plus finement les contrôles, les vérifications et les investigations.
Le quatrième objectif est de renforcer la maîtrise des risques au sens large. Dans le secteur de l’assurance, une situation à risque peut recouvrir des réalités différentes : suspicion de fraude, incohérence documentaire, dérive de gestion, risque d’erreur d’indemnisation, usage atypique d’une garantie, anomalie de prestation, signal de fragilité sur un portefeuille ou besoin de surveillance sur un type de dossier. La détection permet d’anticiper ces situations, de les rendre visibles plus tôt et de réduire le risque qu’elles ne soient identifiées qu’après coup, lorsqu’un préjudice, un coût ou une difficulté opérationnelle s’est déjà matérialisé.
Le cinquième objectif est précisément d’agir à priori et à postériori pour sortir d’une logique exclusivement réactive. La détection peut être mobilisée en amont, avant qu’un dossier ne soit indemnisé, clôturé ou traité selon son parcours standard, afin d’identifier les cas qui nécessitent un examen renforcé, une demande complémentaire ou une orientation spécifique. Elle peut également être mobilisée en aval, à partir des dossiers déjà traités, des prestations versées ou des historiques de gestion, pour repérer des schémas récurrents, comprendre des anomalies passées inaperçues, documenter certaines dérives ou enrichir les dispositifs de contrôle futurs. Cette double temporalité constitue un objectif central de la démarche : permettre à l’organisme de ne pas intervenir uniquement après l’apparition d’un doute ou d’un dommage, mais de développer une capacité de vigilance plus proactive, plus anticipatrice et plus structurée.
Le sixième objectif est de mieux exploiter les données métier déjà disponibles. Les organismes d’assurance disposent souvent d’un patrimoine informationnel considérable, mais celui-ci reste parfois sous-utilisé dans les pratiques quotidiennes de décision. Une démarche de détection structurée vise précisément à transformer ce patrimoine en capacité d’observation. Elle ne se limite pas à accumuler des données ; elle cherche à en faire un support d’analyse et de vigilance, au service des équipes opérationnelles.
Enfin, une démarche de détection des situations à risque poursuit un objectif plus discret mais tout aussi important : installer une culture de vigilance structurée. Lorsqu’elle est bien conçue, elle permet de sortir d’une logique purement réactive, dans laquelle l’organisation attend qu’un problème apparaisse, qu’un doute soit remonté manuellement ou qu’un contrôle tardif mette en évidence une anomalie. Elle aide au contraire à construire une posture plus active, fondée sur l’observation des données, l’identification des signaux pertinents et l’organisation raisonnée de l’attention portée aux dossiers.
Une démarche de détection des situations à risque n’a de sens que si elle repose sur une lecture rigoureuse des informations réellement disponibles dans l’environnement de gestion de l’assureur. En pratique, les données métier d’assurance mobilisables sont nombreuses, mais elles n’ont pas toutes la même utilité, la même qualité ni la même portée. L’enjeu n’est donc pas d’accumuler le plus grand nombre possible de données. Il consiste à identifier celles qui permettent d’éclairer une situation à risque, de révéler des signaux faibles, de mettre en évidence une détection d’anomalies ou d’alimenter une analyse des dossiers plus ciblée.
La première famille de données mobilisables est constituée des données de contrat. Ces informations sont essentielles parce qu’elles permettent de replacer un dossier dans son cadre contractuel et de comprendre la situation observée.
La deuxième famille concerne les données de sinistres, de prestations ou d’indemnisation. Dans l’assurance santé, en prévoyance, en assurance emprunteur ou en assurance de dommages, ces informations sont particulièrement utiles pour repérer des situations atypiques à risque sans constituer à elles seules une preuve de fraude ou d’irrégularité, mais qui peuvent signaler un besoin de vigilance renforcée.
Une troisième famille essentielle est celle des données de gestion. Ces données sont souvent sous-exploitées alors qu’elles constituent un matériau précieux pour comprendre la trajectoire réelle d’un dossier.
Les données relatives aux intervenants peuvent aussi jouer un rôle important : assurés, bénéficiaires, professionnels de santé, employeurs, réparateurs, experts, prestataires, tiers impliqués dans un sinistre ou dans une prestation.
Enfin, une démarche solide de détection des situations à risque suppose de croiser les familles de données plutôt que de les lire isolément. Une date, un montant ou une anomalie documentaire pris seuls peuvent ne rien signifier. En revanche, la combinaison entre une évolution contractuelle, un historique de gestion, un rythme de prestations, un changement de comportement déclaratif et des pièces justificatives incohérentes peut faire apparaître un niveau de vigilance qui n’était pas visible autrement. C’est précisément dans cette logique de croisement des informations, de contextualisation et de mise en relation que les données métier d’assurance prennent toute leur valeur.
Il faut donc insister sur un point : la qualité d’une démarche de détection ne dépend pas uniquement du volume de données disponible. Elle dépend surtout de la capacité à sélectionner les informations pertinentes, à les relier à une problématique métier claire, à les replacer dans leur contexte assurantiel et à les interpréter avec discernement. Autrement dit, les données ne deviennent utiles à la détection que lorsqu’elles sont intégrées dans une véritable démarche méthodologique d’exploitation des données et d’analyse des dossiers.
La détection des situations à risque à partir des données métier d’assurance n’est pas liée à une seule branche, ni à un seul type de dossier. Elle constitue une démarche méthodologique transversale qui peut être mobilisée dans des contextes très différents dès lors qu’un organisme d’assurance cherche à mieux repérer les dossiers sensibles, à renforcer sa lutte contre la fraude, à sécuriser certaines décisions ou à améliorer sa maîtrise des risques. Son intérêt réside précisément dans sa capacité à s’appliquer à des réalités opérationnelles variées tout en conservant une logique commune : exploiter les données produites par l’activité d’assurance pour identifier les situations qui ne doivent pas être traitées comme les autres.
Cette démarche peut d’abord s’appliquer en amont d’une décision ou d’un règlement, c’est-à-dire à un moment où l’organisme doit déterminer si un dossier peut suivre son parcours habituel ou s’il nécessite un examen renforcé. Dans cette logique à priori, la détection sert à repérer, avant indemnisation, avant versement d’une prestation ou avant validation d’une décision, les dossiers dont la chronologie, les pièces, les montants, les récurrences, les changements déclaratifs ou les interactions avec d’autres informations justifient une vigilance particulière. Elle peut alors nourrir une analyse des dossiers plus approfondie, un contrôle documentaire, une demande de pièces complémentaires, une orientation vers une cellule spécialisée ou une priorisation décisionnelle spécifique. Dans cette configuration, la détection agit comme un mécanisme d’anticipation : elle vise à éviter qu’un dossier sensible ne suive un traitement standard faute d’avoir été identifié à temps.
Elle peut également s’appliquer à postériori, à partir des dossiers déjà traités, des prestations versées, des sinistres clôturés ou des historiques de gestion. Dans ce second temps, l’objectif n’est plus seulement de décider quoi faire d’un dossier en cours, mais de relire les flux passés pour repérer des schémas récurrents, des anomalies passées inaperçues, des enchaînements inhabituels, des dérives de portefeuille ou des configurations de fraude qui n’avaient pas été visibles lors du traitement initial. Cette dimension à postériori est essentielle, car elle permet d’enrichir les dispositifs de contrôle, d’améliorer les critères de vigilance, de mieux comprendre certains mécanismes de risque et de faire évoluer les pratiques de gestion à partir de situations déjà observées. En cela, elle contribue directement au passage d’une logique essentiellement réactive à une logique plus proactive de surveillance et de maîtrise des risques.
La démarche trouve aussi sa place dans tous les contextes où l’assureur doit arbitrer entre un grand nombre de dossiers sans pouvoir leur consacrer à tous le même niveau d’attention. Dans un environnement marqué par des volumes importants, des délais contraints et des ressources limitées, la détection des situations à risque permet d’introduire un premier niveau de hiérarchisation. Elle aide à distinguer les dossiers pouvant suivre un traitement courant de ceux qui présentent des caractéristiques justifiant un contrôle, une investigation ou un approfondissement. Cette capacité de ciblage est particulièrement utile lorsque l’organisme cherche à mieux orienter ses équipes de gestion, ses contrôles documentaires, ses investigations fraude ou ses travaux d’audit interne.
La démarche s’applique également à tous les cas où le risque ne résulte pas d’un élément isolé, mais d’une combinaison de signaux qui n’acquièrent du sens qu’une fois rapprochés. Dans l’assurance, une situation à risque ne se manifeste pas toujours par une anomalie flagrante. Elle peut apparaître à travers une succession d’événements, une incohérence entre plusieurs pièces, une fréquence atypique, une évolution inhabituelle du dossier, une répétition de comportements, une articulation singulière entre contrat, prestation, déclaration et historique de gestion, ou encore une accumulation de signaux faibles ou forts. La détection prend ici toute sa valeur, car elle permet de dépasser une lecture fragmentée des dossiers pour organiser une observation plus globale, plus contextualisée et plus utile à la lutte contre la fraude comme à la maîtrise des risques.
Elle est aussi particulièrement pertinente dans les organisations qui souhaitent mieux articuler observation, contrôle et décision. Une démarche de détection n’a pas vocation à produire une alerte abstraite ou un simple signal statistique. Elle devient utile lorsqu’elle alimente une action concrète : contrôle documentaire, réexamen d’un dossier, orientation vers une cellule fraude, surveillance renforcée d’un portefeuille, approfondissement d’une demande d’indemnisation, révision de certaines règles de gestion ou amélioration d’un dispositif de pilotage. En pratique, la détection s’insère donc dans une chaîne plus large où les données métier d’assurance servent à éclairer une décision, à soutenir une investigation, à renforcer un contrôle ou à ajuster une pratique opérationnelle.
Enfin, cette démarche s’applique aussi à la manière dont l’organisme construit ses dispositifs analytiques, organise sa vigilance et prépare une utilisation plus robuste de l’IA dans l’assurance.
En définitive, la détection des situations à risque à partir des données métier d’assurance s’applique partout où un organisme doit décider quoi regarder, quand le regarder et avec quel niveau d’attention. Elle peut intervenir avant une décision, après un traitement, au moment d’un contrôle, dans le cadre d’une investigation, dans une logique de pilotage ou dans la préparation d’un dispositif analytique plus avancé. Sa force ne tient donc pas à une branche d’assurance particulière, mais à sa capacité à organiser une lecture plus précoce, plus ciblée et plus opérationnelle des situations sensibles.
Le premier bénéfice d’une démarche de détection des situations à risque à partir des données métier d’assurance est de renforcer la capacité des organismes à structurer leur lutte contre la fraude sans réduire celle-ci à une logique de réaction ponctuelle ou à quelques signalements isolés. Dans de nombreux contextes assurantiels, la fraude n’apparaît pas sous la forme d’un indice unique, immédiatement identifiable. Elle se manifeste plus souvent à travers des enchaînements d’événements, des incohérences documentaires, des récurrences atypiques, des comportements déclaratifs singuliers, des usages inhabituels d’une garantie ou des configurations de dossier qui, prises séparément, ne suffisent pas à conclure, mais qui justifient une vigilance renforcée lorsqu’elles sont rapprochées. Une démarche structurée de détection permet précisément d’organiser cette lecture, de faire émerger des signaux faibles, d’orienter plus finement les contrôles et d’alimenter les investigations sur des bases plus ciblées.
Cette capacité est d’autant plus importante qu’elle permet d’agir à deux moments complémentaires du traitement assurantiel. D’une part, la détection peut intervenir a priori, c’est-à-dire avant qu’une décision ne soit définitivement prise, avant qu’un règlement ne soit effectué ou avant qu’un dossier ne suive son parcours standard sans contrôle particulier. Dans cette logique, l’exploitation des données métier permet d’identifier plus tôt des situations nécessitant une analyse des dossiers approfondie, une vérification documentaire, une demande d’éléments complémentaires ou une priorisation décisionnelle spécifique. D’autre part, la détection peut également intervenir a posteriori, à partir de dossiers déjà traités, de prestations déjà versées, de sinistres clôturés ou de flux historiques, afin de repérer des schémas récurrents, des anomalies passées inaperçues, des dérives de portefeuille ou des configurations de fraude qui n’avaient pas été visibles lors du traitement initial. Cette double temporalité est essentielle : elle permet de sortir d’une logique purement réactive, dans laquelle l’organisme n’agit qu’une fois le doute remonté ou le dommage constaté, pour évoluer vers une démarche plus proactive, plus structurée et plus anticipatrice.
Le deuxième bénéfice majeur de cette démarche est donc de transformer la manière dont l’organisme organise sa vigilance. Lorsqu’elle est correctement conçue, la détection des situations à risque ne sert pas seulement à repérer des dossiers sensibles ; elle permet de mieux répartir l’attention, de hiérarchiser les vérifications, de concentrer les moyens de contrôle là où ils sont les plus utiles et de mieux articuler les actions de gestion, de surveillance et d’investigation. Elle contribue ainsi à éviter deux écueils fréquents : d’un côté, le traitement uniforme de dossiers qui n’ont pas tous le même niveau d’enjeu ; de l’autre, la dispersion des ressources sur des contrôles trop larges, trop tardifs ou insuffisamment ciblés.
La démarche apporte également un bénéfice direct en matière de maîtrise des risques. En rendant plus visibles certaines situations atypiques, certaines incohérences, certaines répétitions ou certaines combinaisons de signaux, elle aide à repérer plus tôt des dossiers susceptibles de générer un risque financier, documentaire, opérationnel ou décisionnel. Elle ne supprime pas ce risque à elle seule, mais elle réduit la probabilité qu’il reste invisible jusqu’à un stade tardif de traitement. Elle contribue ainsi à sécuriser les processus d’indemnisation, de contrôle et de gestion, tout en améliorant la qualité de la décision sur les dossiers les plus sensibles.
Cette démarche apporte également un bénéfice fort en matière de priorisation décisionnelle. La détection ne se contente pas de faire remonter des signaux ; elle aide à orienter la suite à donner aux dossiers : contrôle documentaire, approfondissement, analyse complémentaire, orientation vers une cellule spécialisée, surveillance renforcée, mise sous vigilance ou simple traitement standard. Elle crée ainsi un lien direct entre l’observation analytique et l’organisation concrète du travail des équipes. Dans des contextes de forte volumétrie, cette capacité à distinguer les dossiers qui nécessitent une action particulière de ceux qui peuvent suivre un traitement courant constitue un gain opérationnel déterminant.
Enfin, la démarche joue un rôle essentiel et déterminant dans la préparation d’usages analytiques plus avancés, y compris en matière d’IA. Un organisme ne peut pas attendre d’un modèle ou d’un outil qu’il détecte correctement les situations sensibles s’il n’a pas déjà clarifié ce qu’il cherche à repérer, quelles données métier d’assurance sont pertinentes, quels signaux faibles méritent une attention particulière et comment les résultats doivent être utilisés dans les processus métier. De ce point de vue, la détection des situations à risque constitue un bénéfice supplémentaire, moins visible mais très structurant : elle oblige l’organisation à formaliser ses cas d’usage, à mieux comprendre ses données et à articuler plus finement l’analyse, la décision et la lutte contre la fraude. Elle ne prépare donc pas seulement de meilleurs contrôles ; elle prépare aussi une exploitation plus robuste et plus réaliste des approches analytiques et de l’IA dans l’assurance.
Quelles sont les idées reçues sur la détection des situations à risque à partir des données métier ?
La première idée reçue consiste à penser que la détection des situations à risque se confond avec la seule lutte contre la fraude. En réalité, la fraude constitue un champ d’application majeur de cette démarche, mais elle n’en résume pas la portée. Une situation à risque peut aussi renvoyer à une incohérence documentaire, à un dossier complexe, à un risque d’erreur d’indemnisation, à une dérive de gestion, à une anomalie de prestation, à une fragilité sur un portefeuille ou à toute configuration nécessitant une vigilance renforcée. Réduire la détection à la seule fraude conduit à sous-estimer sa valeur pour la maîtrise des risques, la qualité de gestion, la priorisation décisionnelle ou l’amélioration des contrôles.
Une deuxième idée reçue est de considérer que la détection intervient uniquement après l’apparition d’un problème, d’un doute ou d’un signalement. C’est précisément l’un des malentendus que cette démarche permet de dépasser. La détection des situations à risque peut être mobilisée à priori, avant qu’un dossier ne soit indemnisé, avant qu’une décision ne soit finalisée ou avant qu’un traitement standard ne suive son cours sans vigilance particulière. Elle peut aussi être mobilisée à postériori, à partir des dossiers déjà traités, des flux historiques ou des prestations versées, afin de repérer des schémas passés inaperçus, de mieux comprendre certaines dérives ou d’ajuster les contrôles futurs. Penser la détection uniquement comme un outil de réaction tardive revient donc à passer à côté de l’un de ses apports les plus structurants : aider l’organisme à évoluer d’une logique principalement réactive vers une logique plus proactive de surveillance, de contrôle et de maîtrise des risques.
Une troisième idée reçue consiste à croire que la détection repose avant tout sur la quantité de données disponible. En réalité, disposer d’un volume important d’informations ne garantit pas, en soi, une détection plus pertinente. Ce qui compte n’est pas seulement le nombre de données, mais leur qualité, leur cohérence, leur traçabilité, leur capacité à être rapprochées et surtout leur utilité au regard d’une problématique métier claire. Une démarche efficace de détection des situations à risque repose moins sur l’accumulation de données que sur la capacité à sélectionner les données métier d’assurance réellement utiles, à les relier à un cas d’usage précis et à les interpréter dans leur contexte. Sans ce travail de structuration, l’abondance de données peut au contraire brouiller la lecture du risque.
Une quatrième confusion consiste à réduire la détection à un score, à une règle automatique ou à un simple outil technique. Un score, un moteur de règles, un tableau de bord ou un dispositif d’alerte peuvent éventuellement faire partie du dispositif, mais ils ne résument pas la démarche. La détection des situations à risque est d’abord une démarche méthodologique : elle suppose de définir les situations à repérer, d’identifier les données métier utiles, de rapprocher les informations, d’interpréter les signaux dans leur contexte, de distinguer les usages à priori et à postériori, puis de relier les résultats à une action concrète — contrôle, blocage, réexamen, orientation, surveillance ou priorisation décisionnelle. Réduire cette démarche à un outil revient à invisibiliser tout le travail de cadrage et d’interprétation qui fait justement sa valeur.
Une cinquième idée reçue, aujourd’hui très répandue, consiste à penser que l’IA pourrait se substituer à cette structuration préalable. Beaucoup d’organismes souhaitent “faire de l’IA” pour détecter la fraude, repérer les anomalies ou orienter les dossiers, comme s’il suffisait d’ajouter une couche technologique aux flux existants. En pratique, cette représentation est trompeuse. Une IA ne sait pas, par elle-même, ce qu’un organisme considère comme une situation à risque, quelles données sont pertinentes, quels signaux ont une valeur métier ni comment les résultats doivent être utilisés dans les processus de gestion. Sans clarification des cas d’usage, sans structuration des données métier d’assurance, sans articulation avec l’analyse des dossiers, la lutte contre la fraude et la décision opérationnelle, l’IA risque de produire des résultats peu interprétables ou peu actionnables. La détection des situations à risque ne constitue donc pas une alternative à l’IA ; elle représente au contraire l’un des prérequis qui permettent à une démarche d’IA de devenir réellement utile.
Enfin, une dernière idée reçue consiste à croire que la détection est un dispositif figé, qu’il suffirait de paramétrer une fois pour toutes. Or une démarche de détection utile évolue avec les flux, les comportements, les pratiques de gestion, les schémas de fraude, les règles de contrôle et les priorités de l’organisme. Les signaux faibles ou forts d’aujourd’hui ne seront pas nécessairement ceux de demain ; certaines anomalies perdront leur pertinence, d’autres apparaîtront. La détection doit donc être pilotée, relue, ajustée et enrichie dans le temps. C’est précisément cette capacité d’évolution qui lui permet de rester utile, crédible et alignée avec les besoins réels de l’organisation.
- Peut-on détecter une situation à risque avant qu’un dossier soit indemnisé ou traité ?
Oui. L’un des intérêts majeurs de la démarche est précisément de permettre une détection à priori, c’est-à-dire avant qu’un dossier ne suive son traitement standard, avant qu’une décision ne soit finalisée ou avant qu’une indemnisation ne soit versée. À partir des données métier d’assurance, l’organisme peut repérer des éléments justifiant une vigilance renforcée : chronologie atypique, incohérences, récurrences inhabituelles, pièces à vérifier ou signaux faibles nécessitant une analyse des dossiers plus approfondie. La démarche peut également être utilisée à postériori sur les flux déjà traités, ce qui permet de renforcer les contrôles futurs et de passer d’une logique réactive à une logique plus proactive.
2.En quoi la détection des situations à risque est-elle utile avant de déployer de l’IA ?
La détection des situations à risque constitue un prérequis méthodologique à une utilisation pertinente de l’IA dans l’assurance. Avant d’automatiser, de scorer ou de modéliser, un organisme doit d’abord savoir quelles situations il cherche à repérer, quelles données métier d’assurance sont réellement utiles, quels signaux ont une valeur métier et comment les résultats doivent être exploités dans les processus de gestion. Sans ce travail préalable, l’IA risque de reposer sur un problème mal défini, des données mal sélectionnées ou des usages peu clairs. La détection aide donc à formaliser les cas d’usage, à structurer l’exploitation des données et à préparer une IA plus robuste, plus interprétable et plus utile.
Les éléments ci-dessous résument les points essentiels à retenir sur la détection des situations à risque à partir des données métier d’assurance : sa définition, sa finalité, son champ d’application et son lien avec la décision et l’intelligence artificielle.
La détection des situations à risque ne se limite pas à la fraude :
Elle sert bien sûr la lutte contre la fraude, mais elle permet plus largement d’identifier des dossiers sensibles, des incohérences, des anomalies, des risques d’erreur d’indemnisation ou des situations nécessitant une vigilance renforcée.
Elle repose sur l’exploitation des données métier d’assurance :
La démarche mobilise les données métier d’assurance produites par les contrats, les prestations, les sinistres, les justificatifs, les historiques de gestion ou les décisions déjà prises. L’enjeu n’est pas d’accumuler des données, mais d’en faire un support d’observation utile à la décision.
Elle peut intervenir à priori comme à postériori :
La détection peut être utilisée avant une décision, une indemnisation ou un traitement standard pour orienter un contrôle, mais aussi après traitement pour repérer des schémas récurrents, des anomalies passées inaperçues ou des dérives à corriger.
Elle permet de passer d’une logique réactive à une logique proactive :
En identifiant plus tôt les dossiers sensibles et en exploitant les retours issus des flux déjà traités, l’organisme peut sortir d’une vigilance déclenchée uniquement par le doute ou le signalement, pour aller vers une démarche plus proactive, structurée et pilotée.
Elle constitue un socle méthodologique pour une IA utile en assurance :
Avant de vouloir automatiser, déployer de l’IA, l’organisme doit savoir quelles situations il cherche à repérer, quelles données sont pertinentes et comment les résultats seront utilisés. La détection des situations à risque fait partie de ce travail de structuration préalable.
Le schéma ci-dessous présente le cheminement général par lequel la détection des situations à risque transforme les données métier en vigilance opérationnelle, avec la double logique à priori / à postériori.