Détecter des situations à risque à partir des données métier d’assurance
Détecter des situations à risque à partir des données métier d’assurance consiste à exploiter les informations produites par l’activité assurantielle pour repérer, le plus tôt possible, des dossiers, des comportements ou des configurations qui justifient une vigilance renforcée. Dans le secteur de l’assurance, cette démarche ne se limite pas à la recherche d’une fraude avérée. Elle vise plus largement à identifier de s anomalies, des incohérences, des récurrences atypiques, des enchaînements inhabituels ou des situations sensibles susceptibles d’avoir un impact sur la gestion, l’indemnisation, la maîtrise des risques ou l’efficacité des contrôles.
Ce sujet est devenu central parce que les organismes d’assurance disposent aujourd’hui d’un volume important de données issues de la souscription, de la gestion des prestations, des sinistres, de l’indemnisation ou encore des échanges avec les assurés et les différents intervenants. Bien exploitées, ces données permettent de dépasser une logique de traitement uniforme ou de réaction tardive, pour aller vers une détection plus structurée, plus ciblée et potentiellement plus précoce des situations à examiner. L’analytique des données joue ainsi un rôle déterminant dans la détection à priori comme dans l’analyse à postériori, dans la priorisation décisionnelle, dans l’orientation des contrôles et dans la préparation d’usages d’intelligence artificielle réellement utiles en assurance.
La détection des situations à risque est devenue un enjeu majeur pour les organismes d’assurance parce qu’ils doivent traiter des volumes croissants de dossiers, de prestations, de sinistres, de demandes d’indemnisation ou d’événements de gestion, sans pouvoir appliquer partout le même niveau d’analyse ni le même niveau de contrôle. Dans ce contexte, la question n’est pas seulement de savoir si un dossier est conforme ou non, mais d’identifier ceux qui présentent des caractéristiques justifiant une attention particulière. L’enjeu est donc de faire émerger, au sein d’un ensemble très vaste de situations ordinaires, celles qui appellent une vigilance renforcée, un contrôle complémentaire, une revue approfondie ou une décision plus prudente.
C’est précisément à ce niveau que l’analytique des données devient indispensable. Elle permet d’exploiter de façon structurée les données déjà produites par les activités d’assurance pour repérer des signaux qui ne sont pas toujours visibles dans une lecture dossier par dossier. Dans un organisme d’assurance, les informations utiles à la détection sont nombreuses : données de souscription, historiques de sinistres, prestations versées, chronologies d’événements, pièces justificatives, informations relatives aux professionnels intervenant dans les dossiers, décisions passées, récurrences de parcours, ou encore séquences d’indemnisation. Prises isolément, ces données ne disent pas nécessairement grand-chose. En revanche, leur mise en relation, leur comparaison et leur analyse peuvent faire apparaître des écarts, des récurrences inhabituelles, des incohérences ou des rapprochements qui justifient un examen plus attentif.
L’analytique est indispensable parce qu’elle permet de transformer un patrimoine de données dispersées en éléments utiles à la décision. Elle donne aux organismes d’assurance les moyens de mieux orienter leur vigilance, de hiérarchiser les dossiers et de concentrer leurs efforts sur les situations les plus sensibles au regard des enjeux de fraude, de maîtrise des risques, d’indemnisation ou de qualité de gestion. Elle ne remplace ni l’expertise métier ni l’analyse humaine, mais elle fournit un cadre de lecture qui permet de mieux repérer ce qui mérite d’être examiné.
Elle joue également un rôle central dans l’évolution des pratiques de détection. Longtemps, la vigilance s’est surtout exercée à postériori, lorsqu’un doute était déjà formulé, lorsqu’un signalement avait été remonté ou lorsqu’une anomalie avait été identifiée au cours du traitement. L’analytique permet d’aller au-delà de cette logique réactive en introduisant une capacité de lecture plus précoce, plus structurée et plus systématique des situations à risque. En ce sens, elle ne se contente pas d’améliorer les contrôles existants ; elle transforme la manière dont l’organisme d’assurance repère, hiérarchise et traite les situations sensibles.
Les approches fondées principalement sur les contrôles manuels, les signalements ponctuels ou l’application de règles isolées ont longtemps constitué le socle de la vigilance en assurance. Elles conservent d’ailleurs une utilité réelle : l’expertise des équipes, la capacité à détecter une incohérence dans un dossier, la connaissance des garanties, des parcours de gestion ou des typologies de fraude restent essentielles. De même, certaines règles de contrôle ou certains signalements métiers peuvent continuer à jouer un rôle important dans l’identification de situations sensibles. Mais ces approches atteignent leurs limites lorsqu’elles deviennent le principal, voire l’unique, mode de détection dans un environnement où les volumes de données, la diversité des situations et la complexité des parcours de gestion se sont fortement accrus.
La première limite tient à la capacité de traitement. Les organismes d’assurance gèrent un nombre élevé de dossiers et de flux, parfois sur plusieurs branches, avec des temporalités de décision courtes et des exigences fortes en matière de qualité de service, de conformité, de maîtrise des coûts et de sécurisation des décisions. Dans ce contexte, il devient difficile de faire reposer la vigilance sur des contrôles manuels systématiques ou sur la seule attention des équipes opérationnelles. Même lorsqu’elles sont expérimentées, ces équipes ne peuvent pas analyser de manière homogène l’ensemble des informations disponibles ni repérer spontanément toutes les récurrences, tous les rapprochements ou toutes les séquences inhabituelles disséminées dans les données.
La deuxième limite concerne la fragmentation de l’information. Un signal de risque n’apparaît pas toujours dans un élément isolé. Il peut résulter d’une combinaison de facteurs : une chronologie particulière, une répétition inhabituelle, un rapprochement entre plusieurs dossiers, une divergence entre des pièces justificatives et des données de gestion, ou encore la récurrence d’un même schéma sur des périodes distinctes. Les approches centrées sur des règles unitaires ou sur la lecture d’un dossier pris séparément ont plus de difficulté à faire émerger ce type de configuration, précisément parce qu’elles n’exploitent pas toujours le potentiel du croisement des données.
La troisième limite est liée à la temporalité de l’action. Les signalements ponctuels et les contrôles manuels interviennent souvent lorsque quelque chose a déjà attiré l’attention : un doute, une anomalie visible, une incohérence déclarative, un contentieux ou un retour du terrain. Cette logique reste nécessaire, mais elle est par nature réactive. Elle suppose qu’un indice ait déjà émergé ou qu’un événement ait déjà conduit à s’interroger sur le dossier. Or l’un des enjeux actuels de la détection consiste justement à ne pas attendre qu’une situation problématique soit déjà visible pour agir. Lorsque l’organisme d’assurance parvient à repérer plus tôt certaines configurations sensibles, il peut mieux orienter ses contrôles, sécuriser davantage certaines décisions et limiter le recours à des vérifications tardives ou dispersées.
Enfin, les approches fondées sur des règles isolées présentent une limite de robustesse et d’adaptabilité. Une règle simple peut être utile pour faire remonter certains cas, mais elle ne permet pas toujours d’appréhender la diversité des situations rencontrées. À l’inverse, elle peut aussi générer un grand nombre de dossiers peu pertinents si elle n’est pas replacée dans un contexte plus large. Plus les parcours de gestion se complexifient, plus les données se diversifient et plus les schémas à risque deviennent mouvants, plus il devient nécessaire de disposer d’une lecture plus globale, plus dynamique et plus structurée. C’est précisément ce que permet l’analytique des données lorsqu’elle est pensée comme un appui à la détection, à la priorisation et à la décision.
Concrètement, l’analytique permet d’abord de mieux lire les données déjà disponibles dans l’organisme d’assurance. Là où un traitement classique appréhende souvent les dossiers de manière isolée, elle permet de replacer chaque situation dans un ensemble plus large d’informations, d’historiques, de récurrences et de comparaisons. Cette capacité change profondément la manière de détecter les situations à risque, car elle rend visibles des éléments qui, sans ce travail de mise en relation, resteraient difficiles à repérer.
Elle permet, en premier lieu, de faire émerger des signaux faibles. Un dossier ne présente pas toujours une anomalie manifeste. En revanche, il peut combiner plusieurs indices modestes qui, pris ensemble, dessinent une situation plus sensible : répétition inhabituelle de certains événements, séquence de prestations atypique, écart par rapport à des schémas habituellement observés, incohérence entre plusieurs informations, chronologie surprenante, ou rapprochement entre plusieurs dossiers qui semblent partager certaines caractéristiques. L’analytique permet de faire apparaître ces configurations sans les réduire à une logique binaire où un dossier serait immédiatement considéré comme frauduleux ou non frauduleux.
Elle permet ensuite de hiérarchiser les situations. Tous les écarts ou toutes les anomalies n’ont pas la même portée, et tous les dossiers ne justifient pas le même niveau d’attention. L’un des apports majeurs de l’analytique est précisément d’aider l’organisme d’assurance à distinguer les situations qui relèvent d’un traitement courant de celles qui nécessitent un contrôle complémentaire, une analyse plus approfondie ou une revue renforcée. En cela, la détection ne vaut pas seulement comme exercice d’identification ; elle prépare aussi la priorisation des contrôles et des décisions.
L’analytique permet également de mieux articuler la lecture à postériori et la détection à priori. Elle peut être utilisée pour relire des historiques, comprendre des schémas déjà observés, repérer des récurrences ou enrichir la connaissance de certaines typologies de risque. Mais elle peut aussi être mobilisée en amont d’un paiement, d’une décision d’indemnisation ou d’un traitement standard, afin de signaler plus tôt les situations qui appellent une vigilance particulière. Cette capacité à intervenir plus tôt est essentielle, car elle permet de faire évoluer la détection d’une logique principalement curative vers une logique plus proactive.
Enfin, l’analytique permet de mieux relier la détection aux objectifs plus larges de l’assurance. Repérer une situation à risque n’est pas une finalité en soi. L’enjeu est de mieux orienter les contrôles, de sécuriser l’indemnisation, de soutenir la maîtrise des risques, d’améliorer la qualité de gestion et, plus largement, d’éclairer la décision. En structurant la lecture des données et en faisant émerger des situations sensibles de façon plus cohérente, l’analytique crée les conditions d’une vigilance mieux ciblée et d’une action plus pertinente. C’est aussi pour cette raison qu’elle constitue un socle important pour les futurs usages d’intelligence artificielle en assurance : avant de chercher à automatiser ou à prédire, encore faut-il savoir quelles données regarder, quels signaux interpréter et quelles décisions on souhaite réellement éclairer.
Réduire la détection des situations à risque à la seule recherche de fraude serait trop restrictif au regard des réalités de l’assurance. La fraude constitue bien sûr un enjeu central, notamment parce qu’elle peut affecter la sinistralité, les coûts d’indemnisation, l’équilibre technique des portefeuilles et la qualité de gestion. Mais, dans la pratique, les situations qui justifient une vigilance renforcée sont plus nombreuses et plus diverses que les seuls cas de fraude avérée ou suspectée. L’intérêt de l’analytique des données est précisément de permettre une lecture plus large des situations sensibles, sans enfermer la détection dans une logique exclusivement binaire.
Dans un organisme d’assurance, une situation à risque peut renvoyer à plusieurs réalités. Il peut s’agir d’une incohérence dans un dossier, d’un enchaînement d’événements inhabituel, d’une répétition atypique de prestations ou de sinistres, d’un usage anormal de certaines garanties, d’un comportement déclaratif surprenant, d’une configuration documentaire fragile, d’un parcours de gestion qui appelle un examen complémentaire, ou encore d’une situation susceptible de générer une erreur d’indemnisation, un paiement indu, un coût évitable ou une décision insuffisamment sécurisée. Toutes ces situations ne relèvent pas nécessairement d’une fraude. En revanche, elles ont en commun de justifier une attention particulière parce qu’elles signalent un écart, une anomalie, une exposition ou une fragilité qui mérite d’être comprise.
Cette distinction est importante, car elle conditionne la manière de concevoir la détection. Si l’on réduit l’analytique à un outil destiné uniquement à “trouver des fraudeurs”, on passe à côté d’une grande partie de sa valeur opérationnelle. Dans les faits, l’analyse des données sert aussi à repérer des zones de vulnérabilité dans les processus, à identifier des dossiers atypiques, à mieux cibler les contrôles, à sécuriser l’indemnisation, à comprendre certaines récurrences de gestion et à améliorer la maîtrise globale des risques. Elle peut ainsi contribuer à prévenir des difficultés avant qu’elles ne se traduisent par un contentieux, une fraude constituée, une dérive de portefeuille ou une dégradation de la qualité de service.
Cette approche plus large permet également d’éviter une confusion fréquente entre signal et preuve. Une situation à risque n’est pas, par nature, une fraude démontrée. Elle désigne un dossier, un comportement ou une configuration qui mérite un niveau d’attention supérieur au traitement standard. L’analytique n’a donc pas pour fonction de qualifier seule juridiquement ou opérationnellement un dossier comme frauduleux ; elle sert à faire émerger des éléments de vigilance, à orienter l’analyse et à aider les équipes à concentrer leurs efforts là où les enjeux sont les plus élevés. C’est précisément cette capacité à distinguer la détection d’un risque de la démonstration d’une fraude qui permet d’inscrire l’analytique dans une logique de maîtrise des risques plus large, plus crédible et plus utile pour l’assurance.
En pratique, cette conception élargie de la détection est particulièrement importante dans les domaines où les situations sensibles peuvent être multiples : prévoyance, assurance emprunteur, santé, auto corporel ou IRD. Dans ces univers, la donnée peut révéler non seulement des suspicions de fraude, mais aussi des dérives de gestion, des parcours atypiques, des incohérences documentaires, des schémas d’indemnisation inhabituels ou des combinaisons de facteurs qui rendent un dossier plus sensible qu’il n’y paraît. La détection des situations à risque doit donc être pensée comme une capacité d’orientation de la vigilance, et non comme un simple filtre de fraude.
L’un des apports les plus importants de l’analytique des données en assurance tient à sa capacité à transformer la priorisation décisionnelle. Dans les faits, un organisme d’assurance ne peut pas appliquer le même niveau d’investigation, de contrôle ou d’examen approfondi à l’ensemble des dossiers qu’il traite. Les volumes sont trop importants, les temporalités de gestion trop contraintes, les ressources d’analyse trop limitées et les enjeux trop hétérogènes pour qu’une logique uniforme soit efficace. La question n’est donc pas seulement de détecter des situations à risque, mais de savoir lesquelles doivent être examinées en priorité, à quel moment et avec quel niveau d’intervention.
Sans démarche analytique structurée, cette priorisation repose souvent sur un mélange de règles historiques, de signalements ponctuels, d’intuition métier, de disponibilité des équipes ou de critères généraux de contrôle. Ces éléments peuvent avoir leur utilité, mais ils ne suffisent pas toujours à hiérarchiser de façon cohérente un ensemble très large de dossiers. Ils exposent aussi l’organisation à un double risque : consacrer du temps à des situations peu sensibles tout en laissant passer des cas plus importants, ou multiplier des contrôles peu ciblés qui mobilisent les équipes sans produire de réelle valeur. L’analytique modifie cette situation en apportant des éléments objectivés de lecture et de hiérarchisation.
Concrètement, elle permet de distinguer plusieurs niveaux de sensibilité parmi les dossiers traités. Certains relèvent d’un traitement standard, d’autres méritent une revue documentaire complémentaire, d’autres encore justifient une investigation plus approfondie ou une validation renforcée avant décision. Cette capacité à segmenter les situations ne repose pas sur un seul indicateur, mais sur la combinaison d’informations qui permettent d’évaluer le niveau d’attention à porter au dossier : nature des événements, historique, fréquence, récurrence, contexte de gestion, écarts observés, enchaînements inhabituels, profil de la situation ou proximité avec d’autres cas déjà identifiés comme sensibles.
L’analytique transforme ainsi la priorisation décisionnelle en la rendant plus structurée, plus explicite et plus étroitement liée aux enjeux réels du dossier. Elle permet de mieux orienter les contrôles, de réserver les analyses approfondies aux situations les plus pertinentes, de sécuriser davantage certaines décisions d’indemnisation, et d’éviter que la vigilance repose uniquement sur la capacité des équipes à repérer manuellement des anomalies. Cette transformation est importante, car elle ne produit pas seulement un gain d’efficacité ; elle modifie la façon dont l’organisme alloue ses ressources et organise sa vigilance.
Cette évolution a aussi un effet direct sur la qualité de gestion. Lorsqu’une organisation parvient à mieux hiérarchiser les dossiers, elle peut limiter les contrôles inutiles sur des cas simples, fluidifier le traitement des situations ordinaires et concentrer son effort d’analyse sur les dossiers les plus complexes, les plus exposés ou les plus incertains. La priorisation devient alors un levier d’équilibre entre maîtrise des risques, qualité de service, sécurisation de l’indemnisation et efficience opérationnelle. Elle ne consiste pas à ralentir systématiquement les décisions, mais à mieux distinguer les cas qui nécessitent une vigilance renforcée de ceux qui peuvent suivre un parcours de gestion plus standardisé.
L’analytique transforme enfin la priorisation en lui donnant une dimension plus proactive. Lorsqu’elle est mobilisée suffisamment tôt dans les processus, elle permet de repérer en amont les dossiers qui appellent un contrôle ou une revue, plutôt que d’attendre qu’un doute apparaisse après paiement, après indemnisation ou après contentieux. En ce sens, elle ne sert pas seulement à classer des dossiers déjà problématiques ; elle contribue à organiser la vigilance avant que les difficultés ne soient pleinement constituées. C’est cette articulation entre détection, hiérarchisation et orientation de l’action qui fait de la priorisation décisionnelle l’un des prolongements naturels de l’analytique des données en assurance.
Le lien entre analytique des données et intelligence artificielle est souvent évoqué en assurance, mais il est parfois mal posé. L’IA est régulièrement présentée comme une réponse directe à des enjeux de fraude, de risque, de contrôle ou d’indemnisation, comme s’il suffisait de déployer un modèle pour améliorer automatiquement la détection ou la décision. En réalité, une IA ne devient utile dans un organisme d’assurance que si un travail analytique préalable a permis de clarifier les objectifs poursuivis, de comprendre les données disponibles, d’identifier les signaux réellement pertinents et de définir les décisions que l’on cherche à éclairer. De ce point de vue, l’analytique constitue moins un complément à l’IA qu’un socle indispensable à sa mise en œuvre utile.
Avant même de parler d’algorithmes, un organisme d’assurance doit être capable de répondre à plusieurs questions structurantes : quelles données métier sont disponibles et suffisamment fiables pour être mobilisées ? Quelles informations décrivent réellement les situations à risque que l’on cherche à détecter ? Quels écarts, quelles récurrences, quelles séquences ou quelles incohérences sont significatives au regard du métier ? À quel moment du processus souhaite-t-on intervenir ? Quelle décision veut-on mieux orienter : un contrôle, une revue documentaire, une validation d’indemnisation, une investigation, un arbitrage de gestion ? Sans ce travail préalable, un projet d’IA risque de reposer sur des données mal comprises, sur des objectifs trop vagues ou sur des usages insuffisamment reliés aux réalités opérationnelles.
L’analytique permet précisément de construire ce cadre. Elle aide à qualifier les données, à comprendre leur sens, à distinguer les informations utiles des données accessoires, à structurer les variables d’intérêt et à documenter les cas d’usage de façon suffisamment précise pour qu’un dispositif d’IA puisse ensuite s’y inscrire. Elle permet aussi de mieux formuler la question métier. Il ne s’agit pas seulement de “détecter la fraude” ou “d’automatiser la décision”, mais de savoir quelles situations doivent être repérées, dans quel contexte, avec quel niveau d’explicabilité, pour soutenir quelle action concrète. Cette clarification est essentielle, car elle conditionne la pertinence des résultats produits par les futurs outils.
L’analytique joue également un rôle décisif dans l’intégration opérationnelle de l’IA. Un modèle, aussi performant soit-il sur le plan technique, n’apportera pas de valeur s’il produit des résultats que les équipes ne comprennent pas, ne savent pas exploiter ou ne peuvent pas relier à leurs processus de gestion. À l’inverse, une démarche analytique bien construite permet de préparer les conditions d’usage de l’IA : elle définit les objectifs de détection, documente les signaux, organise la lecture des situations à risque, précise les modalités de priorisation et ancre le dispositif dans des besoins métier clairement identifiés. Elle rend ainsi possible une IA plus explicable, plus pilotable et plus facilement intégrable dans les décisions d’assurance.
Dire que l’analytique constitue un socle pour une IA utile ne signifie pas qu’elle conduit nécessairement à automatiser la détection ou la décision. Cela signifie qu’elle crée les conditions pour qu’un organisme puisse, le cas échéant, déployer des outils d’IA sur des bases solides, avec une meilleure compréhension des données, des processus, des signaux et des usages. En assurance, l’enjeu n’est donc pas de substituer l’IA à l’analyse, mais de construire une intelligence analytique suffisamment robuste pour que les technologies avancées puissent ensuite s’inscrire dans un cadre utile, crédible et maîtrisable.
L’analytique des données ne produit pas mécaniquement une détection utile du seul fait qu’un organisme dispose de volumes importants d’informations ou d’outils techniques avancés. Pour qu’elle apporte une valeur réelle à la détection des situations à risque, elle doit s’inscrire dans une démarche structurée, ancrée dans les réalités métier et reliée à des décisions concrètes. Plusieurs conditions sont déterminantes à cet égard.
La première concerne la qualité et l’intelligibilité des données mobilisées. En assurance, les informations utiles à la détection proviennent souvent de sources multiples : souscription, prestations, sinistres, arrêts de travail, parcours d’indemnisation, pièces justificatives, historiques de gestion, échanges avec les assurés ou données relatives aux intervenants. Ces données doivent être suffisamment fiables, historisées, rapprochables et compréhensibles pour permettre une lecture cohérente des situations. L’enjeu n’est pas seulement de disposer de beaucoup de données, mais de pouvoir les interpréter correctement, comprendre leur contexte de production et savoir ce qu’elles disent réellement du dossier ou du comportement observé.
La deuxième condition tient à la clarté de l’objectif poursuivi. Une démarche analytique n’a pas la même utilité selon qu’elle cherche à détecter des situations atypiques, à mieux orienter les contrôles, à sécuriser une décision d’indemnisation, à documenter des schémas de fraude, à améliorer le pilotage d’un risque ou à préparer un usage d’IA. Ces objectifs peuvent être liés, mais ils ne se traduisent pas de la même manière dans la construction des analyses ni dans l’exploitation des résultats. Une détection réellement utile suppose donc de savoir précisément quel problème métier on cherche à traiter et quelle décision on souhaite mieux éclairer.
La troisième condition est l’articulation étroite entre lecture analytique et expertise métier. Un signal issu des données n’a pas de valeur en soi s’il ne peut pas être replacé dans le contexte d’une garantie, d’un processus, d’un type de prestation, d’une branche d’assurance ou d’une logique d’indemnisation. Ce qui apparaît comme atypique dans un univers de gestion peut être banal dans un autre. À l’inverse, une séquence apparemment ordinaire peut devenir sensible dès lors qu’elle est lue à la lumière de l’historique du dossier, du parcours de l’assuré ou de certaines règles métier. Une détection utile repose donc sur la capacité à croiser les compétences analytiques avec la connaissance opérationnelle du terrain.
Une quatrième condition essentielle réside dans l’intégration des résultats aux processus de gestion, de contrôle et de décision. Produire des signaux ou des analyses n’a de sens que si ces éléments peuvent être utilisés par les équipes pour orienter un contrôle, déclencher une revue complémentaire, renforcer une validation, hiérarchiser une investigation ou ajuster un pilotage. L’analytique ne doit pas rester un exercice parallèle ; elle doit s’inscrire dans les temporalités et les usages réels de l’assurance. C’est à cette condition qu’elle permet de faire évoluer la détection d’une logique purement rétrospective vers une vigilance plus structurée et plus utile en amont.
Enfin, une détection réellement utile suppose une démarche évolutive. Les pratiques de gestion changent, les données se transforment, les schémas de fraude évoluent, les comportements observés se déplacent et les besoins des organismes ne restent pas stables. Une démarche analytique robuste n’est donc pas figée. Elle doit être suivie, ajustée, enrichie à partir des retours du terrain et réévaluée en fonction des résultats obtenus. Cette logique d’amélioration continue est particulièrement importante lorsque l’analytique doit servir de socle à des projets plus avancés, notamment en matière d’intelligence artificielle.
L’un des premiers points de vigilance consiste à ne pas confondre détection d’une situation à risque et preuve de fraude. L’analytique sert à faire émerger des signaux, à repérer des dossiers atypiques, à hiérarchiser la vigilance et à orienter l’examen des situations. Elle ne conclut pas, à elle seule, à l’existence d’une fraude. Une anomalie, un écart ou une récurrence inhabituelle doivent être replacés dans leur contexte, analysés au regard des règles métier et, si nécessaire, approfondis par une instruction humaine. Confondre signal et conclusion reviendrait à attribuer à la donnée un pouvoir démonstratif qu’elle n’a pas.
Un deuxième point de vigilance tient à l’idée selon laquelle l’analytique ne servirait qu’à “trouver des fraudeurs”. Cette représentation est trop étroite. Dans les faits, elle permet aussi d’identifier des zones de fragilité dans les processus, de repérer des dossiers sensibles, de mieux cibler les contrôles, d’améliorer la priorisation décisionnelle et de sécuriser l’indemnisation. La lutte contre la fraude est un champ d’application important, mais elle n’épuise pas à elle seule la valeur de l’analytique dans l’assurance.
Il faut également se garder de penser que l’analytique remplace l’expertise métier. Elle la complète, la structure et l’éclaire, mais elle ne s’y substitue pas. Un signal analytique n’a de sens que s’il peut être interprété par rapport à des garanties, à des règles de gestion, à des parcours de soins, à des logiques d’indemnisation ou à des pratiques propres à une branche d’assurance. La qualité de la détection dépend précisément de cette articulation entre lecture des données et compréhension métier.
Une autre idée reçue consiste à croire que l’IA pourrait se substituer à l’analytique ou dispenser de ce travail de structuration préalable. En réalité, plus un organisme souhaite développer des usages avancés d’intelligence artificielle, plus il a besoin d’une base analytique solide. Sans clarification des données, des objectifs, des cas d’usage et des signaux pertinents, l’IA risque de produire des résultats peu robustes, peu interprétables ou mal intégrés aux processus de décision.
Enfin, il faut rappeler qu’une démarche analytique n’a de valeur que si elle est reliée à une action. Produire des tableaux, des signaux ou des indicateurs ne suffit pas. L’enjeu est de permettre à l’organisme d’assurance de mieux décider, de mieux contrôler, de mieux prioriser et de mieux sécuriser certaines étapes de gestion ou d’indemnisation. L’analytique devient réellement utile lorsqu’elle s’inscrit dans une chaîne de décision cohérente, comprise par les équipes et ajustée aux besoins concrets de l’organisation.
La détection des situations à risque à partir des données métier d’assurance s’inscrit dans un ensemble plus large de notions qui structurent la compréhension des risques, l’organisation des contrôles et la prise de décision en assurance. Pour que ce cas d’usage soit pleinement utile, il doit être relié à plusieurs concepts déjà présents ou appelés à structurer le corpus documentaire du site.
Le premier concept associé est celui d’analytique des données appliquée à la fraude en assurance. Ce cas d’usage en constitue une traduction concrète. Là où la définition fondatrice expose le périmètre, les objectifs et les principes de cette approche, le présent cas d’usage montre comment elle peut être mobilisée, de façon opérationnelle, pour repérer des situations sensibles dans les processus d’assurance. Il doit donc être lu comme une déclinaison métier de cette base conceptuelle.
Le second concept central est celui de détection des situations à risque. Il ne s’agit pas uniquement d’identifier des fraudes avérées ou suspectées, mais plus largement de faire émerger des dossiers, des comportements ou des configurations nécessitant une vigilance renforcée. Ce concept est directement lié à la capacité à exploiter les données métier pour repérer des anomalies, des récurrences atypiques, des incohérences ou des signaux faibles, sans confondre pour autant détection et qualification définitive d’un dossier.
La priorisation décisionnelle constitue un autre prolongement naturel de ce cas d’usage. Détecter des situations à risque n’a de valeur que si cette détection permet ensuite d’orienter les contrôles, de hiérarchiser les dossiers, de déclencher une revue complémentaire ou de sécuriser certaines décisions. La détection et la priorisation ne relèvent donc pas de deux logiques séparées : la seconde prolonge la première en organisant la manière dont les ressources d’analyse, d’investigation ou de validation sont réparties.
Ce cas d’usage est également lié à la notion de données métier d’assurance. Celles-ci forment le socle de la démarche analytique : données de souscription, historiques de prestations, sinistres, arrêts de travail, pièces justificatives, séquences de gestion, intervenants du dossier ou données d’indemnisation. La compréhension de ces données, de leur sens et de leur contexte de production conditionne la qualité de la détection.
Enfin, ce cas d’usage doit être mis en relation avec les notions de maîtrise des risques, d’indemnisation, de lutte contre la fraude et de socle analytique de l’intelligence artificielle. Il montre en effet comment une démarche de lecture structurée des données peut améliorer la vigilance, renforcer la qualité des décisions, sécuriser certains processus et préparer des usages d’IA réellement utiles parce qu’ils s’appuient sur des cas d’usage clairs, des données comprises et des objectifs métier explicités.
Quelle est la différence entre une détection à priori et une analyse à postériori ?
La détection à priori intervient en amont d’une décision, d’un paiement, d’une indemnisation ou d’un traitement standard. Elle vise à repérer le plus tôt possible les situations qui appellent une vigilance renforcée. L’analyse à postériori intervient après traitement, sur des historiques ou des flux déjà passés, afin de comprendre des schémas, repérer des récurrences, enrichir la connaissance des risques ou améliorer les contrôles. Les deux approches sont complémentaires : la première soutient l’anticipation, la seconde nourrit la compréhension et l’amélioration continue.
Comment la détection des situations à risque aide-t-elle à prioriser les contrôles ?
La détection permet de distinguer les dossiers qui relèvent d’un traitement courant de ceux qui présentent des signaux justifiant un niveau de vigilance supérieur. En mettant en évidence des anomalies, des incohérences, des récurrences atypiques ou des combinaisons de facteurs sensibles, elle aide les organismes d’assurance à mieux répartir leurs efforts de contrôle. La priorisation ne repose alors plus uniquement sur des signalements ponctuels ou des règles générales, mais sur une lecture plus structurée des situations à examiner.
En quoi cette démarche constitue-t-elle un socle pour des usages d’intelligence artificielle en assurance ?
Avant de déployer une intelligence artificielle utile, un organisme d’assurance doit savoir quelles données mobiliser, quels signaux observer, quels cas d’usage traiter et quelles décisions il cherche réellement à éclairer. L’analytique des données permet de construire cette base en qualifiant les données métier, en clarifiant les objectifs de détection, en documentant les situations à risque et en structurant la logique de priorisation. Elle prépare ainsi un cadre d’usage plus robuste pour des projets d’IA réellement exploitables dans les processus d’assurance.
Les éléments ci-dessous résument les idées essentielles à retenir pour comprendre pourquoi l’analytique des données est devenue indispensable à la détection des situations à risque en assurance.
Finalité du cas d’usage :
Exploiter les données métier d’assurance pour repérer plus tôt les situations nécessitant une vigilance renforcée.
Champ de la détection :
La détection ne se limite pas à la fraude : elle couvre aussi les anomalies, incohérences, comportements atypiques et fragilités de gestion.
Apport de l’analytique :
Elle permet de croiser les données, de faire émerger des signaux, de hiérarchiser les dossiers et de mieux cibler les contrôles.
Effet sur la décision :
Elle nourrit la priorisation décisionnelle, sécurise certaines étapes d’indemnisation et améliore la maîtrise des risques.
Lien avec l’IA :
Elle constitue un socle préalable pour des usages d’intelligence artificielle utiles, parce qu’elle clarifie les données, les cas d’usage et les objectifs métier.
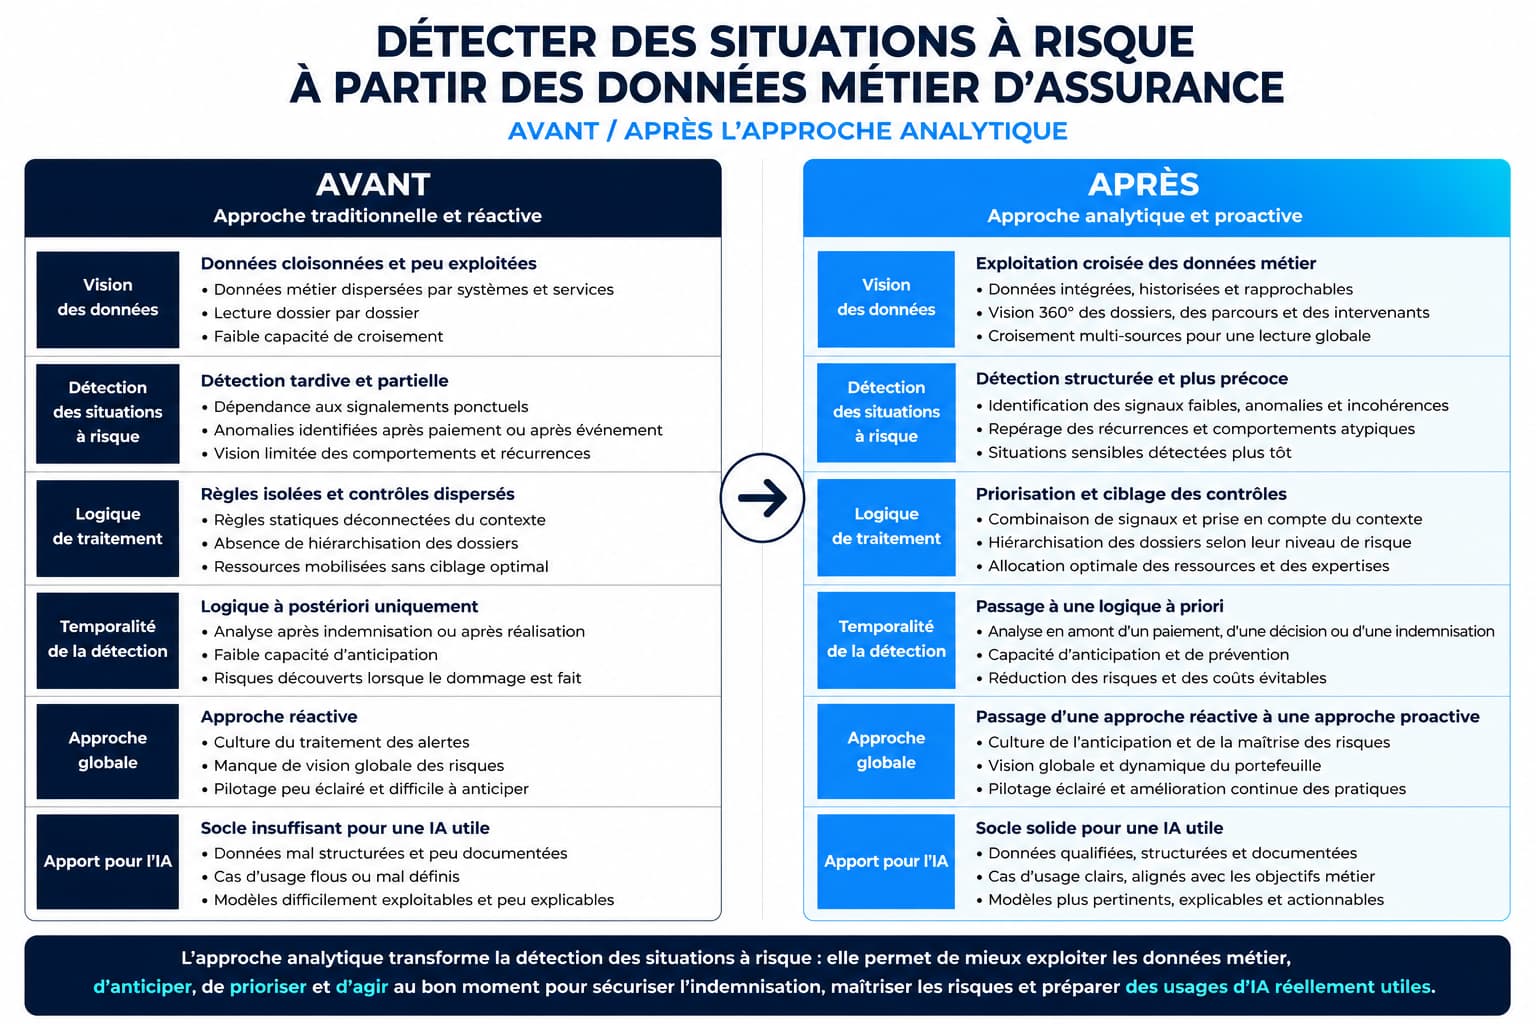
Ce schéma illustre la transformation des pratiques de détection en assurance lorsque l’exploitation des données métier ne repose plus uniquement sur des contrôles manuels, des signalements ponctuels ou des règles isolées. Il montre comment l’approche analytique permet de passer d’une logique réactive et largement à postériori à une démarche plus structurée, plus proactive et davantage orientée vers la priorisation des contrôles, la maîtrise des risques et la préparation d’usages d’IA réellement utiles.